Neden Kendi Yapay Zekanızı Çalıştırmalısınız?
Açık kaynak dünyasındaki hızlı gelişmeler sayesinde yapay zeka, artık yalnızca OpenAI veya Google gibi devlerin sunucularında çalışan bir hizmet olmaktan çıktı. Günümüzde kendi bilgisayarımızın donanım gücünü kullanarak tamamen yerel (Local LLM) modeller çalıştırabiliyoruz.
Peki, ChatGPT veya Claude gibi güçlü bulut servisleri varken neden kendi bilgisayarımızda model çalıştırmak isteyelim?
Yanıt tek bir kelimede saklı: Güvenlik.
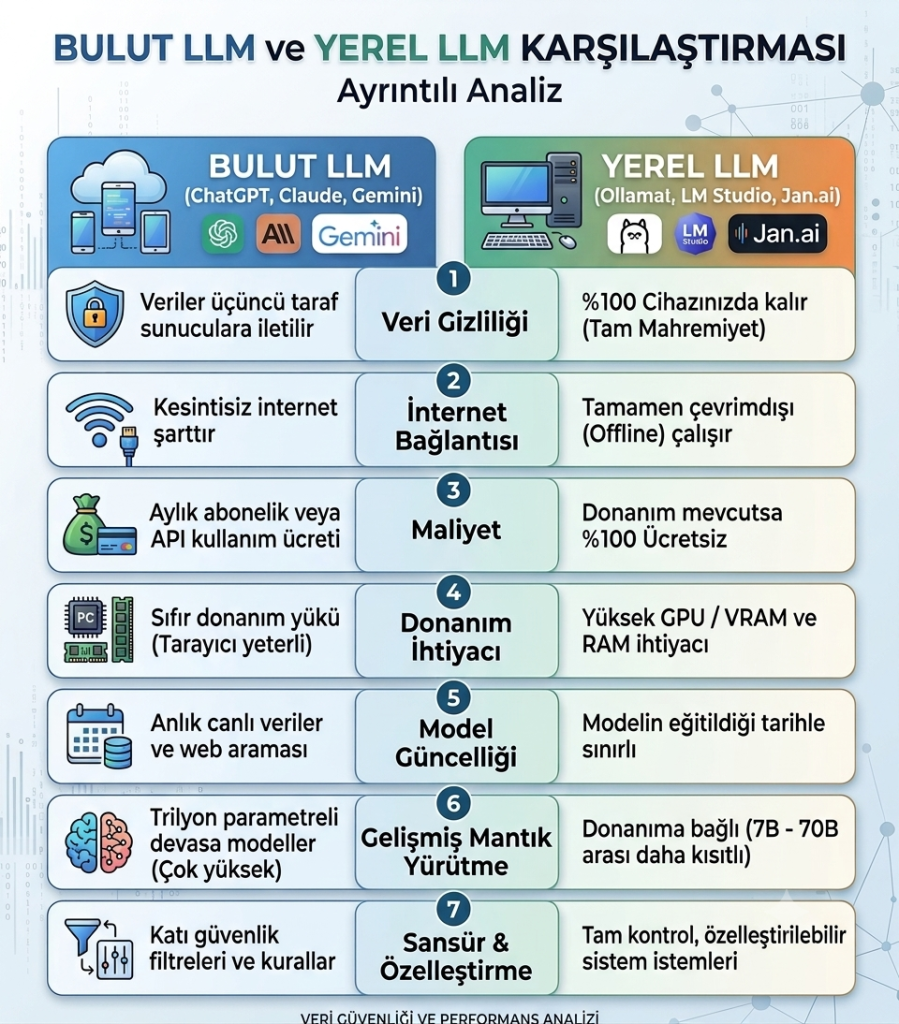
Bir bulut yapay zeka servisine hassas bir şirket belgesi, kaynak kod veya kişisel veri gönderdiğinizde, bu veriler internet üzerinden üçüncü taraf sunuculara iletilir. Her ne kadar şirketler veri gizliliği sözü verse de, veri sızıntıları, API ihlalleri veya model eğitimi riskleri her zaman mevcuttur.
Local LLM (Yerel Yapay Zeka) ise:
- %100 Veri Mahremiyeti: Tüm verileriniz tamamen sizin bilgisayarınızda kalır, internete hiçbir paket gitmez.
- İnternetsiz (Offline) Çalışma: Şantiyede, uçakta veya internet erişimi olmayan izole (air-gapped) sistemlerde kesintisiz çalışır.
- Sınırsız ve Ücretsiz Kullanım: Donanımınız elverdiği sürece abonelik ücreti veya token limiti ödemeden dilediğiniz kadar istek gönderebilirsiniz.
Bilmeniz Gereken Temel Kavramlar: Modeller Belleğe Nasıl Sığar?
Kendi bilgisayarınızda model çalıştırırken işin teknik boyutunda karşınıza çıkacak iki kritik kavram vardır: Bağlam Penceresi (Context Window) ve Kuantizasyon (Quantization).
- Context Window (Bağlam Penceresi): Modelin tek bir sohbet oturumunda aklında tutabildiği “kısa süreli hafıza” kapasitesidir. Örneğin 8K (8.000 token) bağlam uzunluğuna sahip bir model, yaklaşık 6.000 kelimelik geçmiş konuşmayı ve yüklediğiniz dokümanı aynı anda analiz edebilir. Sohbet uzadıkça ve bağlam büyüdükçe donanım üzerindeki bellek (RAM/VRAM) yükü de artar.
- Kuantizasyon (Quantization – Sıkıştırma): “70 milyar parametreli bir model ev tipi bir bilgisayara nasıl sığıyor?” sorusunun cevabıdır. Modeller varsayılan olarak yüksek hassasiyetli matematiksel değerlerle (16-bit / FP16) eğitilir. Kuantizasyon işlemi, bu hassasiyeti kalite kaybını minimumda tutarak 4-bit (Q4) veya 8-bit (Q8) seviyesine indirir. Böylece 16 GB yer kaplayan bir model, mantık yürütme kabiliyetinden neredeyse hiç kaybetmeden 4-5 GB boyutuna düşer.
- GGUF Formatı: Yerel LLM dünyasının standart dosya biçimidir. GGUF formatındaki modeller, hem ekran kartını (GPU) hem de sistem belleğini (RAM) hibrit bir şekilde kullanabilir. Ekran kartınızın VRAM’i yetmediği durumlarda modelin kalan kısmını bilgisayarın ana RAM’ine devrederek çalışmaya devam etmesini sağlar.
Siber Güvenlik, Riskler ve Gerçek Dünya Kullanım Senaryoları
Siber güvenlik perspektifinden bakıldığında yerel modeller, hem kritik bir güvenlik kalkanı hem de dikkatle yönetilmesi gereken yeni bir risk yüzeyi oluşturur.
Siber Güvenlik ve Veri Koruma Kullanımları
- Veri Sızıntısını Önleme (DLP): Şirketlerin hassas kaynak kodları, API anahtarları veya KVKK/GDPR kapsamındaki müşteri verileri bulut servislerine gönderildiğinde ciddi veri ihlali riskleri doğar. Yerel modeller, veriyi tamamen kurum ağı içerisinde tutarak sızıntı riskini sıfıra indirir.
- İzole (Air-Gapped) Sistem Güvenliği: Askeri tesisler, finans kurumları veya kritik altyapılar dış internete kapalıdır. Yerel LLM’ler, internet bağlantısı olmayan bu ortamlarda teknik dokümantasyon sorgulama ve karar destek mekanizması olarak güvenle çalışır.
- Güvenli Kod İnceleme & Zafiyet Analizi: Yazılım ve güvenlik ekipleri, mülkiyeti şirkete ait olan hassas kod bloklarını dış sunuculara sızdırma korkusu olmadan yerel model üzerinden analiz edebilir, tersine mühendislik çıktıklarını yorumlatabilir.
Yerel Yapay Zeka Kullanımındaki Siber Riskler
- Zararlı Model Ağırlıkları (Malicious Weights): Hugging Face gibi platformlardan model indirirken kaynağa dikkat edilmelidir. Özellikle eski
.pkl(Python Pickle) formatındaki model dosyaları, indirilip yüklendiği anda sistemde yetkisiz kod çalıştırabilir (RCE). Güvenlik açısından her zaman.ggufveyasafetensorsformatları tercih edilmelidir.
- Prompt Injection (İstem Enjeksiyonu): Yerel modelinizi yerel dosyalarınıza veya sistem komutlarınıza erişebilen bir araca (RAG/Agent) bağlarsanız, modele okutulan zararlı bir belge/e-posta modeli manipüle ederek sistemde izinsiz işlemler yaptırabilir.
- Yazılım Tedarik Zinciri Riskleri: Kullanılan arayüzlerin (Ollama, LM Studio vb.) ve arkasındaki açık kaynak kütüphanelerin güncel tutulmaması, yerel makinenizde güvenlik zafiyetlerine yol açabilir.
Donanım Rehberi: Bilgisayarınız Yerel LLM İçin Yeterli mi?
Yerel yapay zeka modellerinin çalışma hızını ve sınırlarını belirleyen en kritik bileşen ekran kartı hafızasıdır (VRAM). İşlemci (CPU) ve ana sistem belleği (RAM) modelleri çalıştırabilse de, akıcı ve saniyede yüksek kelime (token) üreten bir deneyim için yükün ekran kartında olması gerekir.
Donanım Bileşenlerinin Rolü
- Ekran Kartı (GPU & VRAM): En vital bileşendir. Model ağırlıkları VRAM’e yüklendiğinde işlem en yüksek hızda gerçekleşir. Nvidia (CUDA) desteği en geniş yazılım ve kütüphane uyumluluğunu sunar. AMD tarafında ise ROCm / Vulkan desteği gelişmektedir.
- Apple Silicon (Birleşik Bellek / Unified Memory): M serisi işlemcili Mac cihazlar, sistem RAM’ini GPU ile ortak kullanır. Bu mimari, yüksek VRAM’li standart ekran kartlarına kıyasla çok daha düşük bütçeyle 70B gibi devasa modelleri çalıştırma imkanı tanır.
- Sistem Belleği (RAM): Ekran kartı VRAM’inin yetmediği durumlarda GGUF formatı sayesinde modelin bir kısmı ana RAM’e aktarılır. Minimum 16 GB, rahat bir kullanım için 32 GB tercih edilmelidir.
- Depolama (SSD): Modeller genellikle 4 GB ile 40 GB arasında yer kaplar. Yükleme sürelerini kısaltmak için NVMe SSD şarttır.
VRAM Kapasitenize Göre Çalıştırabileceğiniz Modeller
- 8 GB VRAM (Giriş Seviyesi): 7B – 8B parametreli kuantize (Q4) modeller. (Örn: Llama 3 8B, Mistral 7B, Gemma 2B/7B) — Günlük görevler, özetleme ve basit kod yardımı için idealdir.
- 12 GB – 16 GB VRAM (Orta Seviye): 8B – 14B parametreli gelişmiş modeller veya daha yüksek bağlam penceresi (Context Window). (Örn: Qwen 14B, Phi-3) — Daha karmaşık mantık yürütme ve teknik metin analizi.
- 24 GB+ VRAM / RTX 3090-4090 (Üst Seviye): 32B ve 70B kuantize modeller. (Örn: Llama 3 70B Q4, Command R) — Üst düzey kodlama, derin zafiyet analizi ve karmaşık RAG senaryoları.
- 36 GB – 128 GB Apple Unified Memory: 70B ve üzeri modelleri tek bir masaüstü cihazında ekonomik şekilde çalıştırmak isteyenler için en pratik seçenek.
Pratik Kurulum Rehberi: 3 Adımda Başlayın
Kendi bilgisayarınızda model çalıştırmak için karmaşık kodlama bilgisine veya saatlerce süren konfigürasyonlara gerek yoktur. Günümüzde bu süreci sıradan bir masaüstü uygulaması yükleme seviyesine indiren iki popüler ve güvenli araç öne çıkmaktadır:
A) LM Studio ile Kurulum (Görsel Arayüz / GUI)
- İndirin ve Kurun:
lmstudio.aiadresinden işletim sisteminize (Windows, macOS, Linux) uygun sürümü indirip kurun. - Model Arayın ve İndirin: Uygulama içindeki arama çubuğuna çalıştırmak istediğiniz modeli yazın (Örn:
Llama-3-8BveyaMistral-7B). Bilgisayarınızın VRAM kapasitesine uygun kuantize bir GGUF dosyasını (önerilen:Q4_K_M) seçip indirin. - Sohbeti Başlatın: “Chat” sekmesine geçin, üst menüden indirdiğiniz modeli seçin ve tıpkı ChatGPT kullanır gibi yerel modelinizle konuşmaya başlayın.
B) Ollama ile Kurulum (Komut Satırı & API Esnekliği)
- Kurulumu Yapın:
ollama.comadresinden işletim sisteminize uygun kurulum dosyasını çalıştırın. - Terminalden Çalıştırın: Terminalinizi (veya PowerShell) açıp tek satırlık şu komutu girin: Bash
ollama run llama3 - Kullanıma Hazır: Model otomatik olarak indirilecek ve terminal üzerinden anında yanıt vermeye başlayacaktır. Arka planda açılan yerel API (Port 11434) sayesinde bunu kendi yazılımlarınıza da kolayca entegre edebilirsiniz.
Yerel yapay zeka (Local LLM) kullanımı; veri mahremiyetini ve siber güvenliği merkeze alan bireyler ile kurumlar için bir lüks değil, hızla standart haline gelen bir gereksinimdir. Doğru donanım ve kuantize model tercihleriyle dış dünyaya tek bir veri paketi bile sızdırmadan kendi yapay zeka asistanınızı güvenle çalıştırabilir, dijital bağımsızlığınızı koruyabilirsiniz.